

 Cihat Murat Yüksel
8 dk okuma
LLM nedir? Büyük dil modelleri nasıl çalışır, markanızı nereden tanır
LLM, sıradaki metin parçasını tahmin ederek yazar. Token, RAG ve halüsinasyon kavramları, markanız hakkında verilen yanıtı denetlememize yardımcı olur.Püf
İçindekiler 0 başlık
LLM, çok büyük metin kümeleriyle eğitilen, kendisine verilen metnin devamındaki parçaları tahmin ederek yanıt üreten ve Türkçede büyük dil modeli adıyla anılan bir yapay zekâ modelidir. Bu parçaları olarak adlandırırız.
Biz pazarlama işlerinde modelin yazma becerisiyle markaya ilişkin bilgisini ayrı değerlendiririz. Akıcı bir hizmet açıklaması, doğru hizmet açıklaması demek değildir. Marka adını tanıması da güncel adresi veya fiyatı bildiğini göstermez. Bu yüzden hem modele verdiğimiz kaynağı hem ürettiği yanıtı kontrol ederiz.
Bir LLM markanızı eğitim verisinden ve yanıt sırasında eriştiği kaynaklardan tanır; biz marka bilgisini tutarlı, güncel ve erişilebilir tutarız.
LLM nedir, ne demek?
LLM, İngilizce “Large Language Model” ifadesinin kısaltmasıdır; Türkçesi büyük dil modelidir. Model, eğitimde karşılaştığı dil örüntülerinden yararlanarak yeni metin üretir. Örneğin bir hizmet metnini e-posta taslağına dönüştürürken aynı bilgiyi başka bir anlatımla kurmasını isteriz. Hizmetin ne olduğunu modelden tahmin etmesini beklemeyiz.
Yapay zekâ modelleri arasında OpenAI’ın GPT, Google’ın Gemini, Anthropic’in Claude ve Meta’nın Llama aileleri bulunur; ChatGPT, GPT ailesiyle ilişkilidir. Biz pazarlama ekibinde model adından önce yapılacak işi tanımlarız: taslak yazmak, verilen belgeleri karşılaştırmak veya sağladığımız veriyi yorumlamak. Her işte yanıtı değerlendirmek için farklı bir kaynak gerekir. Ürün açıklamasında ürün metnini, rapor yorumunda raporun kendisini esas alırız.
Büyük dil modelleri nasıl çalışır?
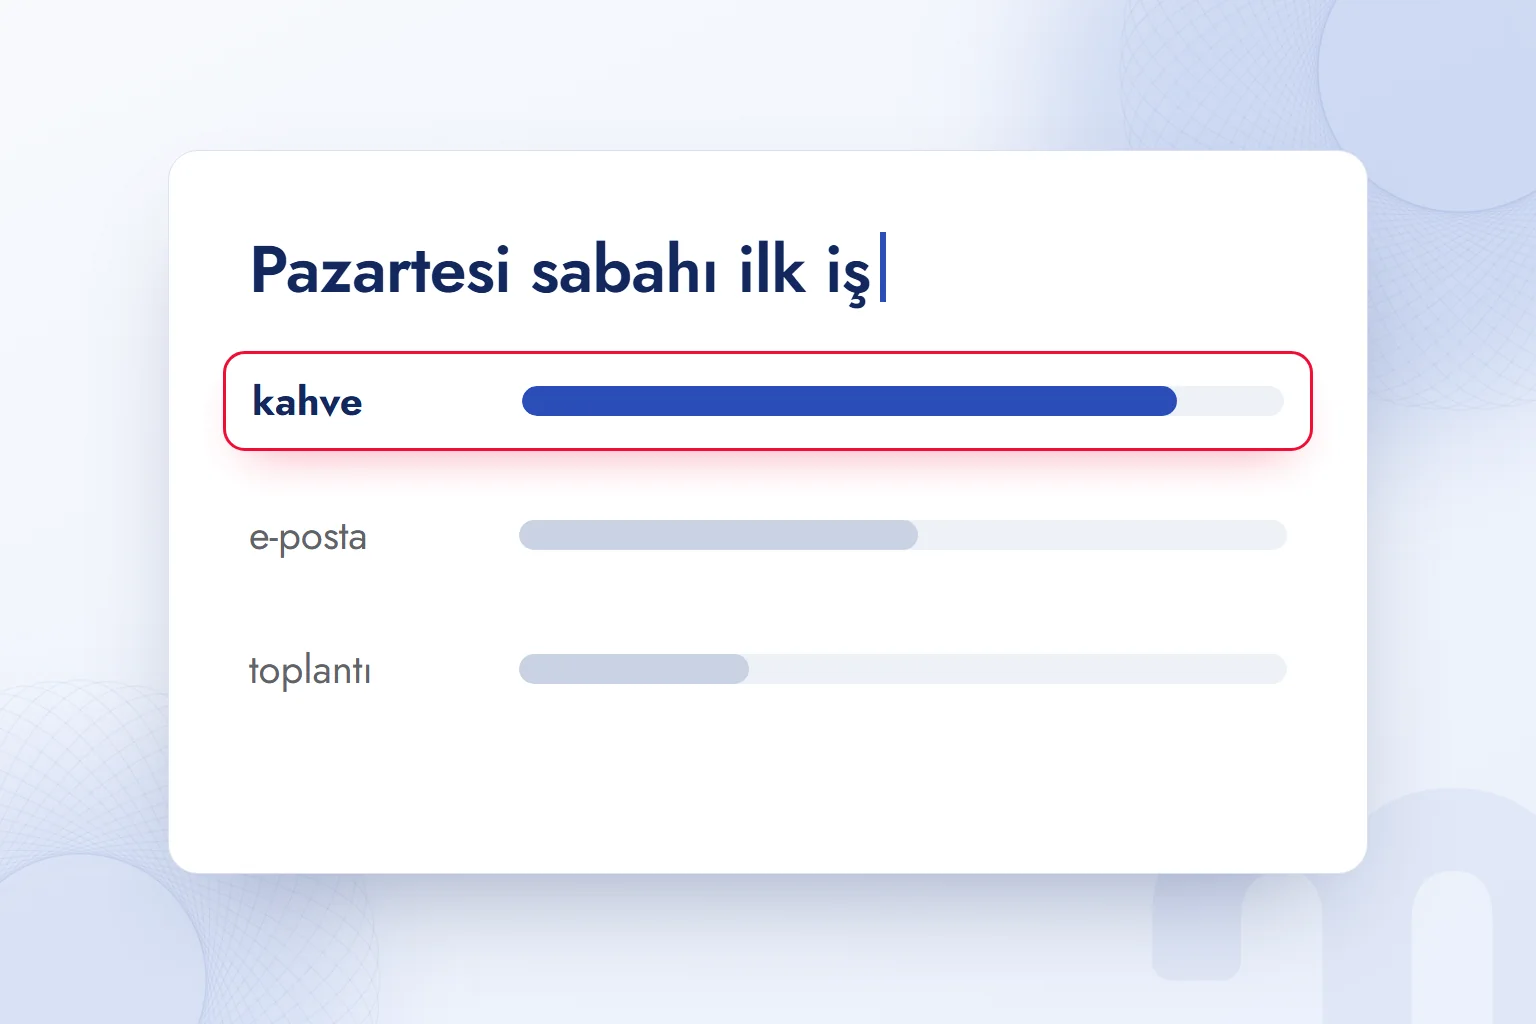
Büyük dil modelleri, önceki metni dikkate alarak sıradaki token’ı tahmin eder ve bu işlemi tekrarlayarak yanıtı oluşturur. Her yeni parça metne eklenir; ardından model bir sonraki parçayı üretir. Uzun bir paragraf da bu üretim sırasıyla ortaya çıkar.
“Toplantıdan sonra müşteriye” diye başlayan bir cümleyi düşünelim. Devamına yazılacak sözler, öncesindeki metne bağlıdır. Biz istemde bir tekliften söz edersek teklif bağlamı, rapordan söz edersek rapor bağlamı sağlar, yanıtı bu bilgiyle yönlendiririz. Modelin ürettiği devamın akıcı olması, müşteriye ilişkin ayrıntıların doğru olduğunu kanıtlamaz.
Günümüz büyük dil modellerinin çoğu, Google araştırmacılarının önerdiği transformer mimarisine dayanır. Pazarlama açısından belirleyici ayrım şudur: modelin yaptığı üretim, olası metin devamını kurmaktır. Biz şirket bilgisi, fiyat veya hizmet kapsamı istediğimizde doğrulama işini kaynak metinle yaparız. Yazının doğal görünmesiyle bilginin dayanağını aynı ölçüt saymayız.
Token nedir, bağlam penceresi ne işe yarar?
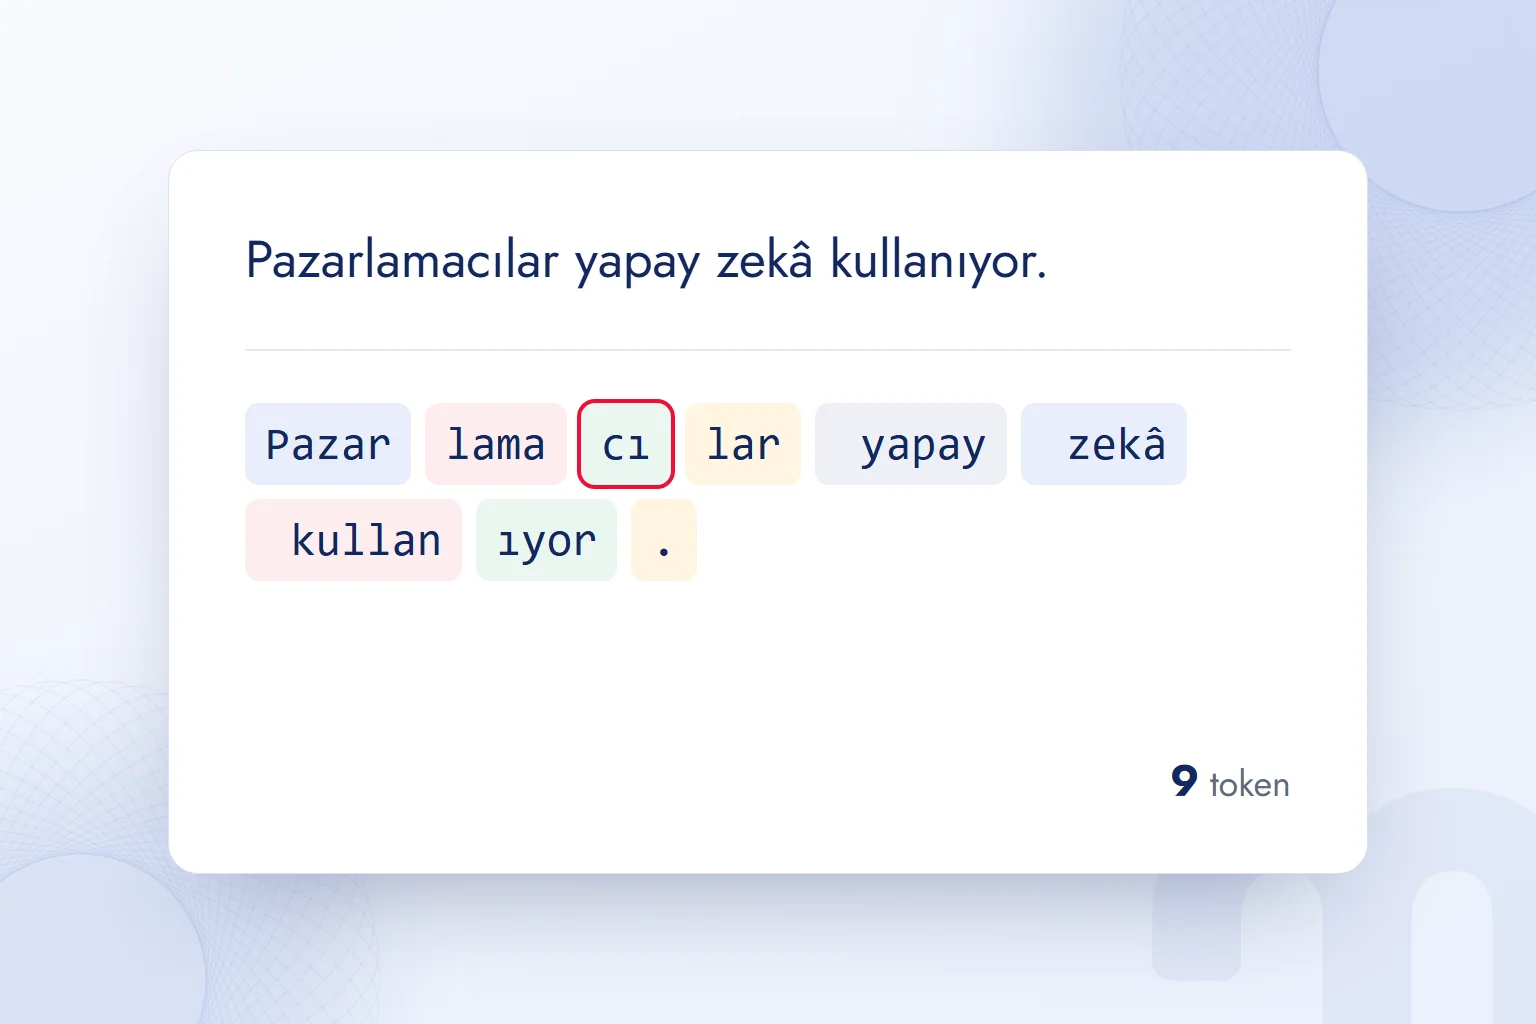
Token modelin işlediği metin birimidir; bağlam penceresi, modelin bir anda dikkate aldığı token sayısının sınırını belirler. Bir sözcük tek token’a ya da birden fazla token’a ayrılır. Türkçe gibi eklemeli dillerde sözcüklerin parçalara bölünmesi sıktır.
Biz bu nedenle kelime sayısını token sayısıyla eşitlemeyiz. Uzun bir kaynak metin hazırlarken yalnız sayfa sayısına bakmayız; görevle ilgili bölümleri seçer, hangi bilgiyi kullanacağımızı açık tutarız. Bağlam penceresini modelin bütün eğitim verisini o anda önünde tuttuğu bir alan gibi düşünmeyiz.
Kullanım ücretleri çoğunlukla token üzerinden hesaplanır. Belge özetleme işinde kaynak metnin uzunluğunu, beklediğimiz yanıtı ve kullanılacak modelin sınırını birlikte değerlendiririz. Gereksiz metni ayıklarız; hizmetin kapsamını değiştiren bir koşulu ise kısaltma uğruna çıkarmayız.
| Kavram | Ne demek | Pazarlamada karşılığı |
|---|---|---|
| LLM | Sıradaki metin parçasını tahmin eden büyük dil modeli | Taslak ve özet üretiriz |
| Token | Modelin işlediği metin birimi | Metin uzunluğunu ve kullanım ücretini değerlendiririz |
| Bağlam penceresi | Bir anda dikkate alınan token sınırı | Göreve uygun kaynak bölümlerini seçeriz |
| Eğitim verisi | Modelin eğitildiği metin kümeleri | Marka bilgisinin güncelliğini kontrol ederiz |
| RAG | Kaynaktan bilgi getirerek yanıt üretme yaklaşımı | Güncel belgeyi yanıtın dayanağı yaparız |
| Halüsinasyon | Gerçek olmayan bilginin emin bir dille üretilmesi | İddiaları kaynakla karşılaştırırız |
| İnce ayar | Belirli görev için ek veriyle eğitim | Önce istem ve kaynak metinle işi çözeriz |
LLM güncel bilgiyi nereden alır?
LLM güncel bilgiyi yanıt sırasında yapılan aramadan veya kendisine sağlanan belgelerden alır. Eğitim verisinin bir kesim tarihi vardır; model bu tarihten sonraki bilgiyi kendi başına bilmez. Biz güncel fiyat, adres veya hizmet kapsamı sorusunda önce kaynağın güncelliğini kontrol ederiz.
Arama, yanıt hazırlanırken dışarıdan bilgi bulmayı sağlar. Belge verdiğimizde ise kullanılacak kaynak metni biz sağlarız. RAG, İngilizce “retrieval-augmented generation” ifadesinin kısaltmasıdır; bilgi getirme destekli üretim anlamına gelir. Bu yaklaşımda yanıt, getirilen kaynak bilgisiyle hazırlanır.
Örneğin bir hizmetin kapsamı değiştiğinde modele güncel hizmet metnini verir, açıklamayı bu metne dayanarak hazırlatırız. Kaynakta bulunmayan bir hizmeti eklemesini istemeyiz. Arama kullanıyorsak yanıtın hangi sayfaya dayandığına bakarız. Güncel soruyu yalnız eğitim verisinden gelen yanıtla kapatmayız; eski bir kaynağı tekrar sunmak da güncellik sorununu çözmez.
Halüsinasyon nedir, model neden uydurur?
Halüsinasyon, modelin gerçek olmayan bilgiyi akıcı ve emin bir dille üretmesidir; model olası sözcük dizisini kurarken eksik bilgiyi uydurarak tamamlar. Yanlış fiyat, yanlış kurucu adı ve gerçekte bulunmayan kaynak bu hatanın örnekleridir.
Biz yanıtın kesin tonunu doğruluk kanıtı saymayız. Bir marka açıklamasını incelerken hizmet adını hizmet sayfasıyla, adresi iletişim bilgisiyle, fiyatı onaylı fiyat kaynağıyla karşılaştırırız. Kaynak gösterilmişse ilgili metnin iddiayı gerçekten destekleyip desteklemediğini okuruz. Yalnız kaynak adının yazılması kontrolü tamamlamaz.
İstemimize “Yalnız verilen metindeki bilgileri kullan; eksik bilgiyi eksik olarak belirt” koşulunu ekleriz. Ardından çıkan yanıtı aynı kaynakla denetleriz. Kaynakta fiyat yoksa yayın taslağına fiyat koymayız. Yanlış kurucu adı varsa önce doğru bilgiyi doğrular, sonra bu bilgiyi taşıyan sayfaları ve yanıtı düzeltiriz. Desteksiz bir iddiayı daha yumuşak yazarak metinde tutmayız.
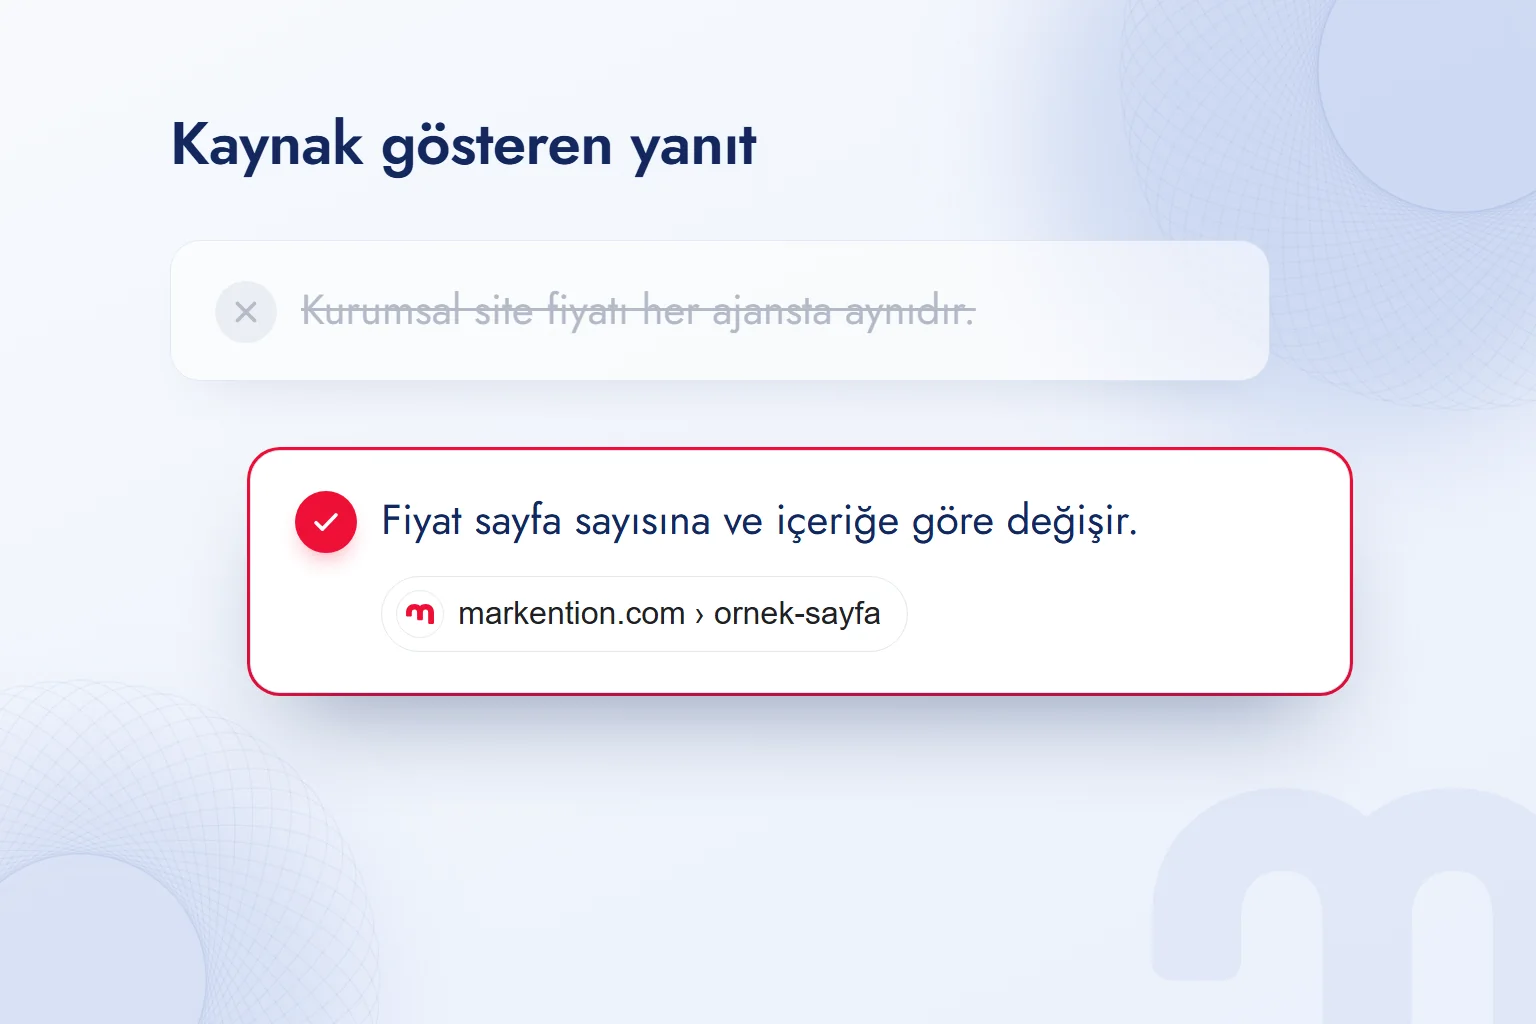
LLM markanızı nereden tanır?
LLM markanızı eğitim verisinde karşılaştığı bilgilerden ve yanıt sırasında aradığı kaynaklardan tanır. Biz marka görünürlüğünü değerlendirirken modelin ne söylediğini, arama kullanılıp kullanılmadığını ve hangi kaynağa dayandığını birlikte inceleriz.
Üç ihtimal var:
- Markayı hiç bilmiyor → Eğitim verisinde marka bilgisi bulunmaması ve aramanın açık olmaması durumunda kaynak ve erişimi kontrol ederiz; markayı anlatan sayfaları açık ve anlaşılır hâle getiririz.
- Eski bilgi veriyor → Eğitim verisinin kesim tarihini dikkate alır, güncel marka sayfasını ve yanıt sırasında arama kullanımını kontrol ederiz; eski adresi güncel kaynakla karşılaştırırız.
- Yanlış bilgi veriyor → Halüsinasyonu ve kaynak tutarsızlığını araştırırız; yanlış hizmet tanımını, marka adını veya iletişim bilgisini geçtiği kaynaklarda düzeltiriz.
Markanın LLM yanıtlarında doğru görünmesi için şu sırayla çalışırız:
- Marka bilgisini netleştiririzMarka adını, hizmet tanımını, adresi ve iletişim bilgisini doğrular, esas alacağımız metni belirleriz.
- Kaynakları eşitlerizWeb sitesini, işletme profillerini ve diğer kaynakları karşılaştırır; çelişen veya eski bilgileri düzeltiriz.
- Erişimi kontrol ederizArama botlarının ilgili sayfalara erişimini ve robots.txt kurallarını inceler, görünmesini istediğimiz kaynakları erişilebilir tutarız.
- Doğrudan yanıt yazarızMarkanın ne yaptığını ve hangi hizmeti verdiğini ilgili sayfada açık bir cümleyle anlatırız.
- Yanıtı doğrularızModelin marka açıklamasını yeniden inceler; hizmet, adres ve iletişim bilgisini kaynaklarla karşılaştırırız.
Tarama denetiminde robots.txt nedir yazısındaki izin çerçevesini kullanırız. Biz GEO danışmanlığı çalışmasında içerik tutarlılığıyla kaynak erişimini birlikte ele alırız. Tek bir doğru yanıtı bütün marka bilgisinin düzeldiğine kanıt saymayız; kontrolü hizmet ve iletişim sorularında da sürdürürüz.
Pazarlama ekibi LLM’i nasıl kullanır?
Pazarlama ekibi LLM’i taslak üretimi, belge özetleme ve sağladığı veriyi analiz etme işlerinde kullanır; sonucu editör olarak doğrularız. Biz görevi seçerken hangi çıktıyı istediğimizi ve doğrulama kaynağımızı baştan belirleriz.
Üç ihtimal var:
- Taslak üretiyoruz → İstemi ve kaynak bilgiyi verir, çıkan metni editör denetiminden geçiririz; modelin eklediği hizmet ve fiyat iddialarını kontrol ederiz.
- Belge özetliyor veya karşılaştırıyoruz → Kaynak metinleri sağlarız; özette kapsamı değiştiren eksikleri, karşılaştırmada belgelerle uyuşmayan ifadeleri düzeltiriz.
- Ölçüm ve analiz yapıyoruz → Veriyi biz veririz; yanıttaki rakamları raporla karşılaştırır, modelin eksik ölçümü kendiliğinden tamamlamasını kabul etmeyiz.
Belge karşılaştırmasında örnek isteğimiz şöyledir: “Verdiğimiz iki hizmet metnini karşılaştır. Ortak hizmetleri ve kapsam farklarını ayrı yaz. Her farkın hangi metne dayandığını belirt; belgelerde bulunmayan hizmet ekleme.” Yanıtı okurken yalnız farklı sözcükleri işaretleyen satırlarla gerçekten farklı hizmet anlatan satırları ayırırız. Editör olarak kararımızı belgenin içeriğine dayandırır, modelin yorumuyla hizmet kapsamını değiştirmeyiz.
İnce ayar, modeli belirli bir görev için ek veriyle eğitmektir. Çoğu pazarlama işini istem ve kaynak metinle çözeriz. Önce görevi netleştirir, kullanılacak belgeyi verir ve çıkan metni denetleriz. İstemi prompt ne demek yazısındaki görev ve kaynak ayrımına göre kurarız.
LLM kullanırken hangi hatalar yapılır?
LLM kullanırken temel hatalar, eğitim bilgisini güncel kabul etmek, eksik kaynağı modele tamamlatmak ve akıcı yanıtı doğrulanmış saymaktır. Biz düzeltmeyi hatanın kaynağından başlatırız.
Uzun istemde ürün bilgisi yoksa yalnız daha fazla talimat eklemeyiz; gerekli kaynak metni sağlarız. Yanlış adres veren yanıtı düzeltirken web sitesindeki eski adresi bırakmayız. Rapor yorumundaki rakamı da modelin açıklaması ikna edici olduğu için kabul etmeyiz.
Yayına hazırladığımız metinde her hizmet, fiyat ve marka bilgisinin dayanağını kontrol ederiz. Kaynak eksikse önce bilgiyi tamamlar, ardından taslağı yeniden değerlendiririz. Markanın yapay zekâ yanıtlarındaki görünürlüğüne ilişkin içeriklerimiz GEO yazılarımız içinde yer alır.
Sık sorulan sorular
LLM nedir, kısaca?
LLM, büyük metin kümeleriyle eğitilen ve sıradaki token’ı tahmin ederek yazan yapay zekâ modelidir. Açılımı “Large Language Model”, Türkçesi büyük dil modelidir.
Bir token bir kelime midir?
Her zaman değildir; bir sözcük bir veya birden fazla token’a ayrılır. Türkçe gibi eklemeli dillerde sözcüklerin parçalanması sıktır.
Bağlam penceresi neyi sınırlar?
Modelin bir anda dikkate aldığı token sayısını sınırlar. Biz kaynak metnin uzunluğunu ve görev için gerekli bölümlerini buna göre değerlendiririz.
LLM güncel bilgiyi kendiliğinden bilir mi?
Eğitim verisinin kesim tarihinden sonrasını kendi başına bilmez. Güncel bilgi için yanıt sırasında arama veya sağlanan belgeler gerekir.
RAG ile ince ayar arasındaki fark nedir?
RAG, yanıtı getirilen kaynak bilgisiyle üretme yaklaşımıdır. İnce ayar ise modeli belirli bir görev için ek veriyle eğitmektir.
Model markam hakkında yanlış bilgi verirse ne yaparız?
Yanıtı güncel marka kaynaklarıyla karşılaştırır, tutarsız hizmet ve iletişim bilgilerini düzeltiriz. Kaynak erişimini kontrol eder, yeni yanıtı yeniden doğrularız.
Bu konuda devam edin
 Podcast nedir? Markalar için podcast’in işleyişi ve yayın kanallarıYazıyı oku
 ChatGPT’de Reklam Vermek: Ads Manager, Hedefleme ve İlk Kampanya RehberiYazıyı okuEn çok okunan
 Title ne demek? Title etiketi nasıl yazılır, H1’den farkıYazıyı oku
 Segmentasyon nedir? Segment türleri ve GA4’te kitle kurulumuYazıyı oku
 Browser ne demek? Tarayıcı nasıl çalışır, site neden farklı görünürYazıyı oku
 Yapay zekâ ile fotoğraf düzenleme: ürün fotoğrafında arka plan silme, netleştirme ve genişletmeYazıyı oku
 Google’da reklam verme: Google Ads hesabı, ilk kampanya, bütçe ve ölçümYazıyı oku
 TikTok keşfet saatleri: en iyi paylaşım saatini hesap verisiyle bulmakYazıyı oku
Soru & Cevap
0 yorumHenüz soru yok; ilk soruyu siz sorabilirsiniz.