

 Damla Kütük
8 dk okuma
robots.txt nedir, nasıl oluşturulur? Yapay zekâ botlarına izin ayarı
Robots.txt dosyası botlara sitenin tarama kurallarını bildirir. Oluşturma, Search Console testi, yapay zekâ botlarına izin ayarı ve noindex farkı.Püf
İçindekiler 0 başlık
Bir robots.txt dosyası, sitenin kök dizininde bulunan ve uyumlu arama motoru tarayıcılarına veya yapay zekâ botlarına, web sitesindeki hangi sayfa ve yolları tarayabileceklerini bildiren düz metin dosyasıdır. Kuralları üzerinden eşleştiririz.
Biz tarama kararını botun geliş amacına göre veririz. Arama sonuçlarında görünmek, model eğitimine içerik sağlamak ve reklam açılış sayfasını inceletmek ayrı izinlerdir. Genel grupta kapattığımız bir yolun özel bot grubunda da kapalı kaldığını varsaymayız; her grubun kurallarını ayrıca kontrol ederiz.
Bir robots.txt dosyası tarama iznini düzenler; sayfayı dizinden çıkarmak için taramaya açık sayfada noindex kullanırız.
robots.txt nedir?
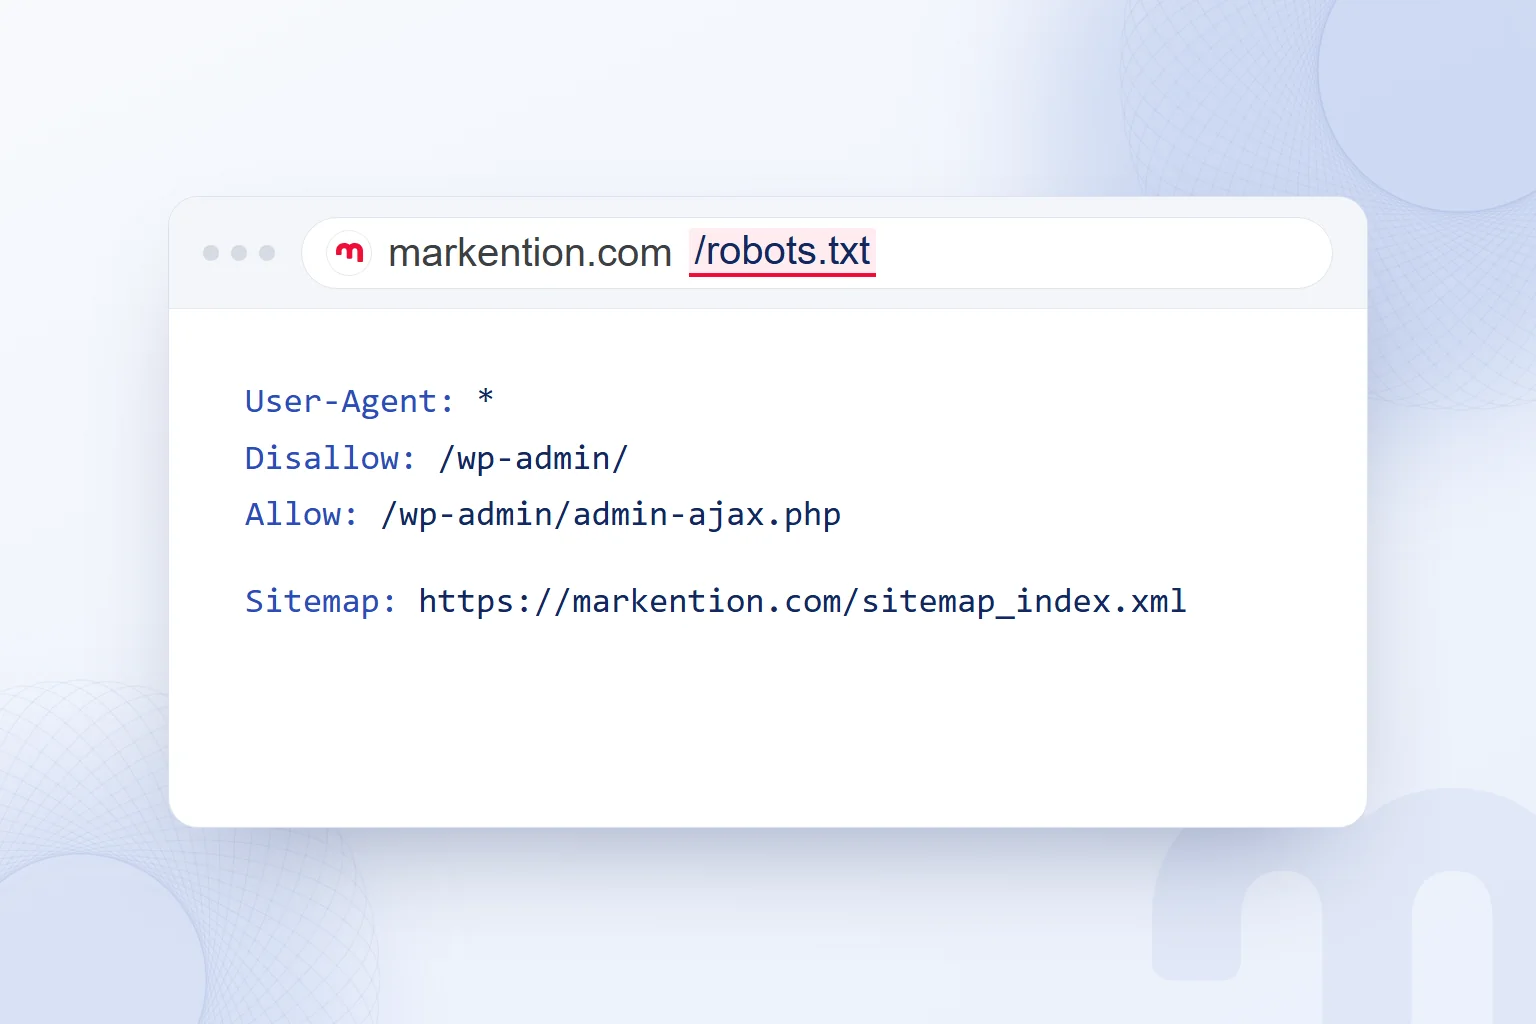
Bir robots.txt dosyası, botlara sitenin tarama kurallarını bildiren metin dosyasıdır; markention.com için adresi markention.com/robots.txt’dir. Dosya kök dizinde bulunur. Her alt alan adı ve protokol için kapsam ayrıdır; birinin dosyasındaki kuralı diğerine uygulanmış saymayız.
Dosya, uyumlu botlara hangi yolları ziyaret etmemelerini söyler. Google robotu Googlebot için yazdığımız kuralla yapay zekâ botlarının kurallarını ayrı değerlendiririz. Tarama iznini kapatmak, sayfanın Google dizininden çıkarıldığı anlamına gelmez.
Biz robots.txt’yi bir erişim politikası olarak kullanırız. Dosya bir rica listesidir, güvenlik kilidi değildir; kurala uymayan botu sunucu veya güvenlik duvarı durdurur. Üye alanını yalnız buraya yazarak korumaya çalışmayız. Kapsam ve konum kurallarını Google’ın robots.txt belirtimi ayrıntılı anlatır.
robots.txt nasıl çalışır, hangi kuralları okur?
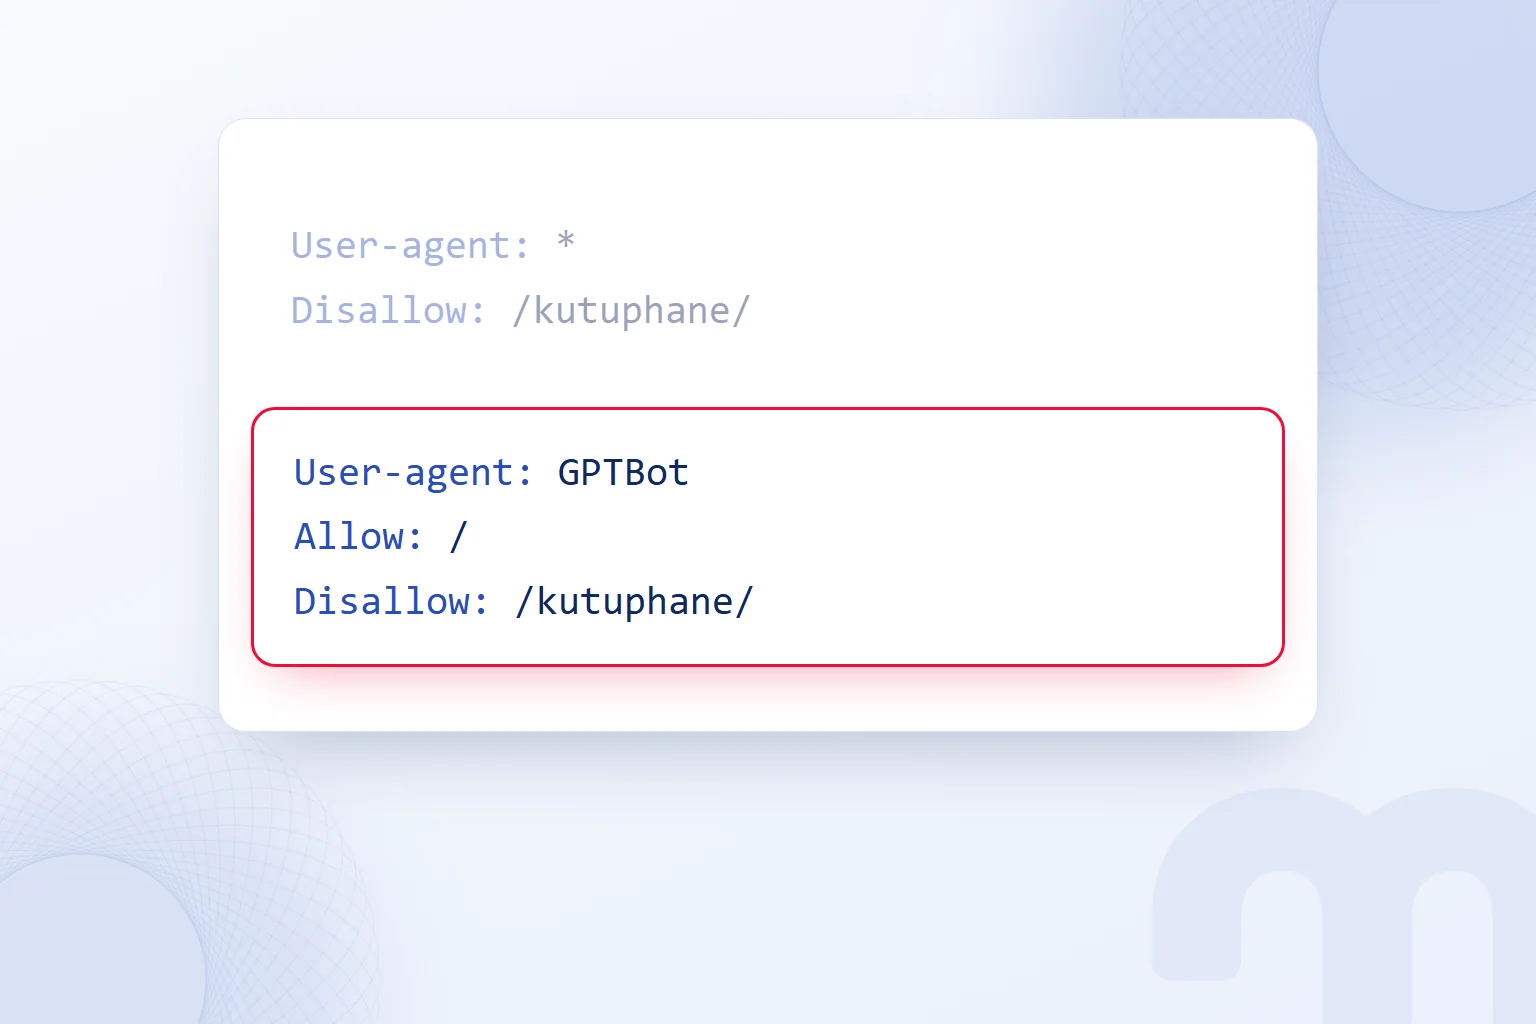
Bot, kendisine uyan en özel kullanıcı aracısı grubunu seçer ve o gruptaki yol kurallarını okur. Kendi adını bulan bot genel (*) grubu okumaz. Örneğin “User-agent: GPTBot” grubu varsa yalnız “User-agent: *” altında kapattığımız /kutuphane/ yolunu GPTBot için de kapatmış olmayız.
Google dört alanı destekler: “User-agent” botu, “Allow” izin verilen yolu, “Disallow” yasaklanan yolu, “Sitemap” site haritasının adresini bildirir. Alan adlarında büyük/küçük harf ayrımı yoktur; yol değerlerinde vardır. Bu nedenle /Kutuphane ile /kutuphane aynı kural değildir.
Yol içinde “*” sıfır veya daha çok karakteri, “$” adresin sonunu belirtir. Gerçek dosyamızdaki “Disallow: /feed$” sonu /feed olan yolu hedefler. Google “crawl-delay” alanını okumaz. Biz dosyada satır bulunmasını yeterli saymayız; ilgili botun o alanı destekleyip desteklemediğine de bakarız.
robots.txt nasıl oluşturulur?
Dosyayı bot gruplarını ve yol izinlerini belirleyerek oluşturur, sitenin kök adresinden erişilecek biçimde yayımlarız. WordPress’te önce sanal robots.txt çıktısını ve bunu yöneten eklenti ayarlarını kontrol ederiz; dosya üzerinden yönetimde kök dizine robots.txt yerleştiririz.
Bir editördeki metinle tarayıcıda görünen çıktının aynı olduğunu doğrulamadan işlemi tamamlamayız. Biz mevcut kuralları saklar, yeni kuralın hangi gruba ait olduğunu belirler ve değişikliği bu grubun içinde yaparız.
Botun bütün siteyi taramasını istemiyorsak kendi grubuna “Disallow: /” yazarız. Açtığımız grupta “Allow: /” kullanır, kapalı kalacak yolları ayrıca belirtiriz.
- Amacı belirlerizArama, eğitim ve reklam incelemesi için hangi botlara izin vereceğimizi ayrı kararlaştırırız.
- Yolları seçerizYönetim ve site içi arama gibi taranmasını istemediğimiz yolları listeleriz.
- Grupları kurarızBot adlarını “User-agent” satırlarına yazar, “Allow” ve “Disallow” kurallarını ilgili gruba ekleriz.
- Çıktıyı yayımlarızWordPress’te sanal dosya ve eklenti çıktısını ya da kök dizindeki dosyayı düzenler, site haritası adresini ekleriz.
- Sonucu doğrularızKök adresteki dosyayı açar, genel ve özel gruplarda aynı yolu ayrı ayrı kontrol ederiz.
“Robots txt generator” adıyla sunulan üretici araçları başlangıç taslağı için kullanırız; hangi içeriğin eğitime açık kalacağına ve hangi yolların kapanacağına kendimiz karar veririz. Hazır metni siteye taşımadan önce kendi yol listemizle karşılaştırırız.
robots.txt nasıl test edilir?
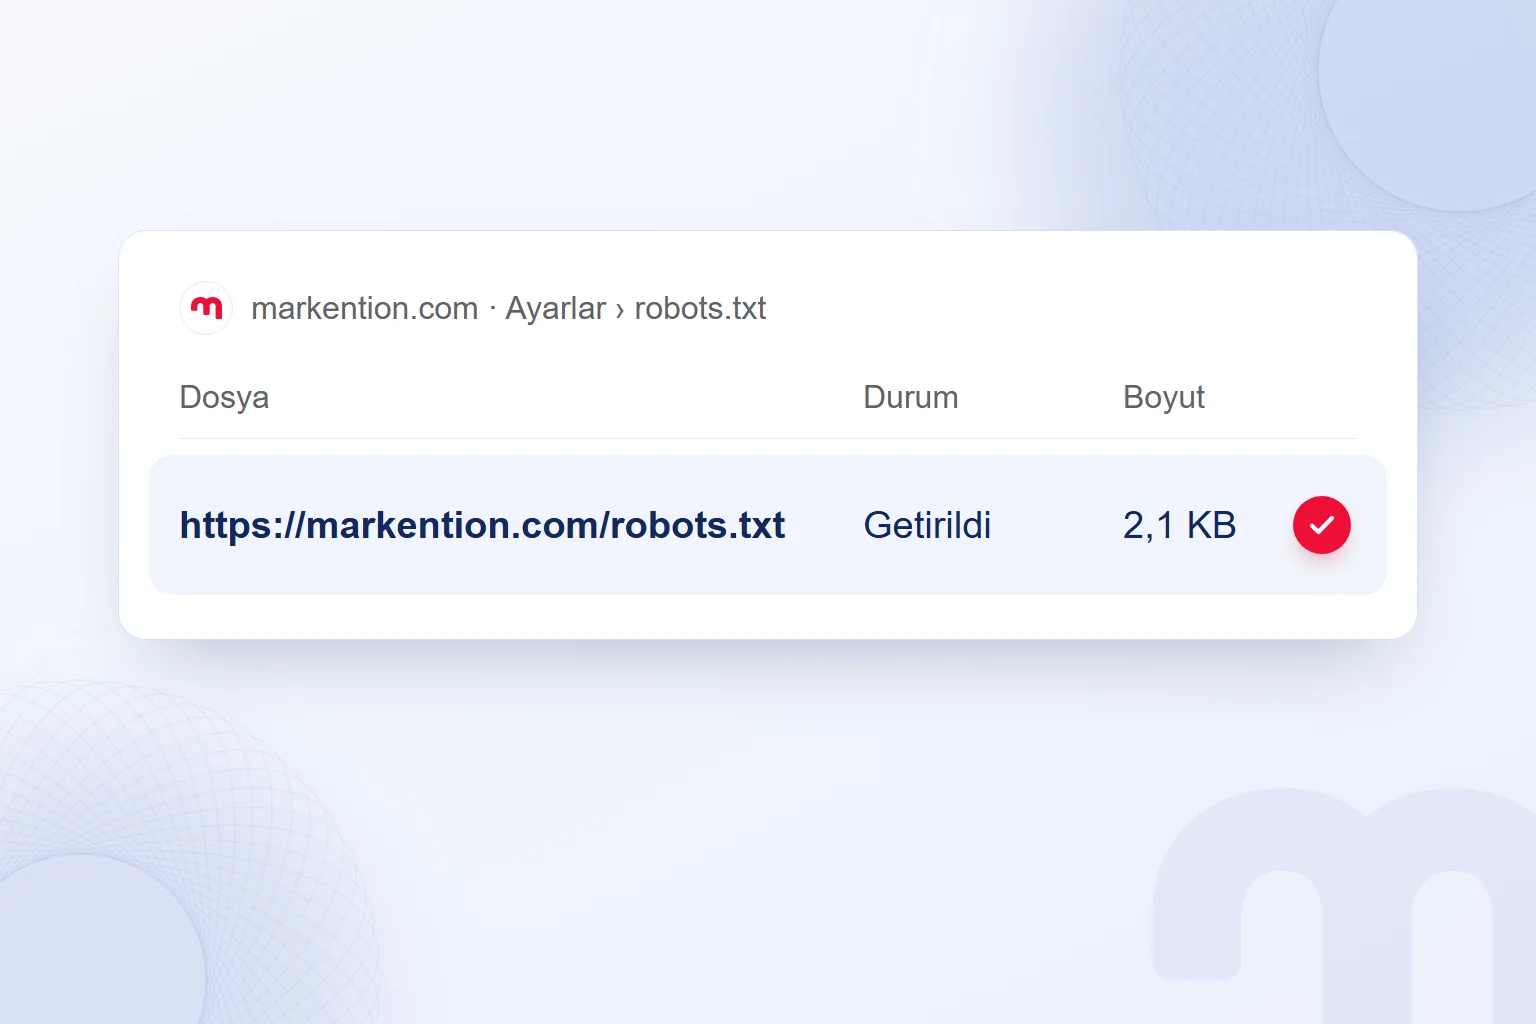
Dosyayı Search Console’daki robots.txt raporuyla ve bot–adres eşleşmesini sınayan kontrol araçlarıyla test ederiz. Search Console’da Ayarlar › robots.txt yolu, Google’ın bulduğu dosyaları, son getirme durumunu ve hataları gösterir. Eski robots.txt Test Aracı’nın yerini robots.txt raporu aldı.
Önce tarayıcıda dosyanın erişilebilirliğine, ardından raporda Google’ın getirdiği dosyaya bakarız. “Robots txt tester” veya “robots txt checker” araçlarında aynı sayfa adresini genel grup ve özel bot adıyla ayrı sınarız. Böylece genel gruptaki yasağın özel gruba taşınmadığı durumu yakalarız.
Sunucu yanıtını da kontrol ederiz. Google, 429 dışındaki 4xx yanıtlarında dosya yokmuş gibi kısıtsız tarar. Google’ın belirtimine göre 5xx hatasında ilk 12 saat tarama durur; ardından son önbellek kopyası 30 güne kadar kullanılır. Bu yüzden erişim hatasını bir engelleme yöntemi olarak kullanmayız.
Bir değişikliğin hemen görünmemesini tek başına yanlış kural diye yorumlamayız; dosyanın alınma durumunu ve önbellek süresini birlikte değerlendiririz.
Yapay zekâ botları hangileri, ne için gelir?
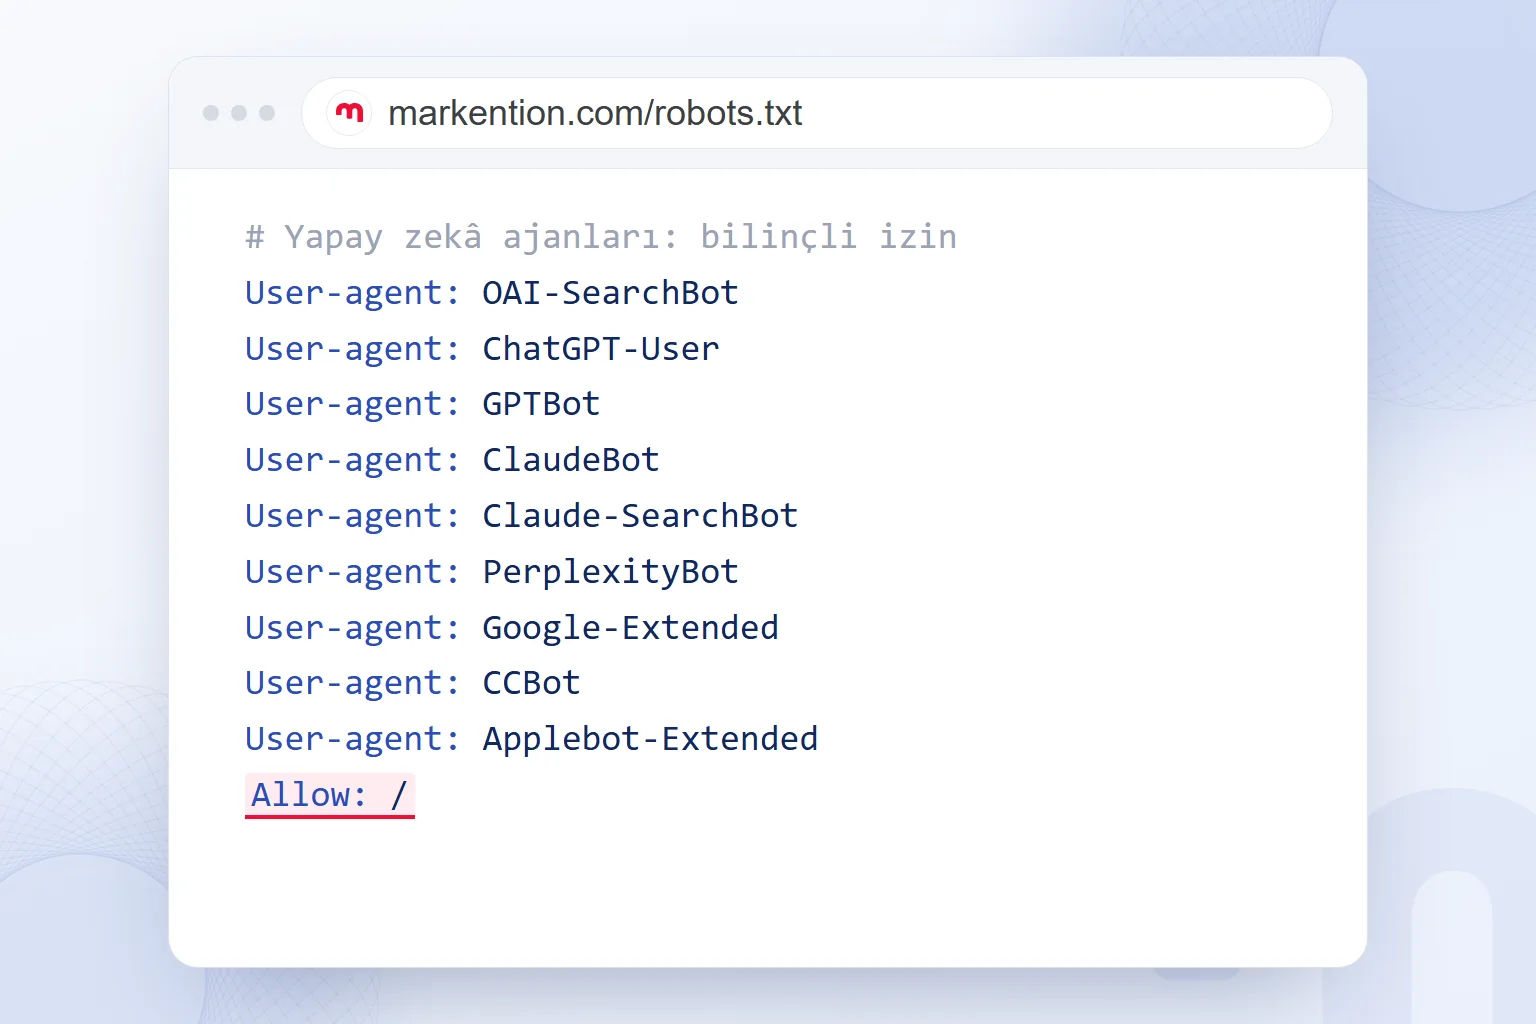
Yapay zekâ botları arama, eğitim, kullanıcı isteği veya reklam incelemesi için gelir; izin kararını bu amaçlara göre ayırırız. Her belirteç bağımsız tarayıcı değildir: Google-Extended ve Applebot-Extended içerik kullanımını denetleyen belirteçlerdir.
| Belirteç | Şirket | Amaç | robots.txt |
|---|---|---|---|
| OAI-SearchBot | OpenAI | ChatGPT aramasında gösterim | Arama izni |
| GPTBot | OpenAI | Temel modellerin eğitimi | Eğitim izni |
| ChatGPT-User | OpenAI | Kullanıcının başlattığı işlemler | Kurallar uygulanmayabilir |
| OAI-AdsBot | OpenAI | Reklam açılış sayfasını inceleme | Açılış sayfası açık olmalı |
| ClaudeBot | Anthropic | Model eğitimi | Eğitim grubunda değerlendiririz |
| Claude-SearchBot | Anthropic | Arama için dizinleme | Arama grubunda değerlendiririz |
| PerplexityBot | Perplexity | Yanıtlarda gösterim ve bağlantı | Arama grubunda değerlendiririz |
| Google-Extended | Gemini eğitimi ve grounding | Ürün belirteciyle yönetilir | |
| CCBot | Common Crawl | Açık web arşivi | Arşiv taramasını yönetiriz |
| Applebot-Extended | Apple | Yapay zekâ eğitimi | Denetim belirteciyle yönetilir |
OpenAI’ın bot belgesine göre OAI-SearchBot ile GPTBot ayarları bağımsızdır. OAI-SearchBot’u engelleyen siteler ChatGPT arama yanıtlarında gösterilmez; gezinme bağlantısı olarak görünmeleri mümkündür. Değişikliğin arama tarafına yansıması yaklaşık 24 saat sürer. ChatGPT-User için robots.txt kurallarının uygulanmayabileceği açıkça belirtilir.
Google-Extended, Gemini eğitimi ve yanıt sırasında Arama dizininden içerik sağlama anlamındaki grounding kullanımını yönetir. Google’ın yaygın tarayıcılar belgesine göre Google Arama’ya dahil edilmeyi etkilemez ve sıralama sinyali değildir.
OAI-AdsBot reklam olarak gönderilen açılış sayfasını politika uyumu için inceler; topladığı veri eğitimde kullanılmaz. OpenAI reklam yardım merkezine göre robots.txt veya Cloudflare engeli varsa sayfa incelenemez. Biz ChatGPT’de reklam vermek için hazırlanan sayfada bu botun erişimini ayrıca kontrol ederiz.
Yapay zekâ botlarına izin mi, engel mi?
İzin kararını sitenin görünürlük hedefi, eğitim tercihi ve içerik erişim sınırı belirler. Biz markention.com’da arama, yanıt ve eğitim botlarına izin veriyor, iç yolları kapalı tutuyoruz.
Üç ihtimal var:
- Görünürlük isteyen hizmet markası → Arama, yanıt ve eğitim botlarını açık tutarız; markention.com’daki tercihimiz budur.
- Özgün araştırma veya ücretli içerik yayımlayan site → Eğitim botlarını kapatır, arama botlarını açık bırakırız; iki izni bağımsız düzenleriz.
- Üye alanı bulunan site → İlgili yolları taramaya kapatırız; içerik korumasını ayrıca sunucu ve erişim denetimiyle sağlarız.
Gerçek dosyamızda dokuz yapay zekâ belirteci aynı gruptadır ve “Allow: /” satırıyla izin alır. Yönetim ve arama yollarını bu grupta yeniden kapatırız. Genel gruptaki yasaklar özel gruba aktarılmadığından bu tekrar gereklidir.
Biz AI erişim kontrolü kapsamında botun adına, seçtiği gruba ve hedeflediği yola birlikte bakarız. İzin değişikliği daha önce toplanmış veriyi geri almaz; yeni tercihi geçmiş verinin silinmesi olarak sunmayız.
robots.txt ile noindex farkı nedir?
Bir robots.txt kuralı taramayı, noindex ise sayfanın dizinde bulunmasını yönetir; noindex’in okunması için sayfa taramaya açık kalmalıdır. Taramaya kapalı sayfa başka yerlerden bağlantı alıyorsa Google içeriğini okumadan adresi dizinde gösterebilir.
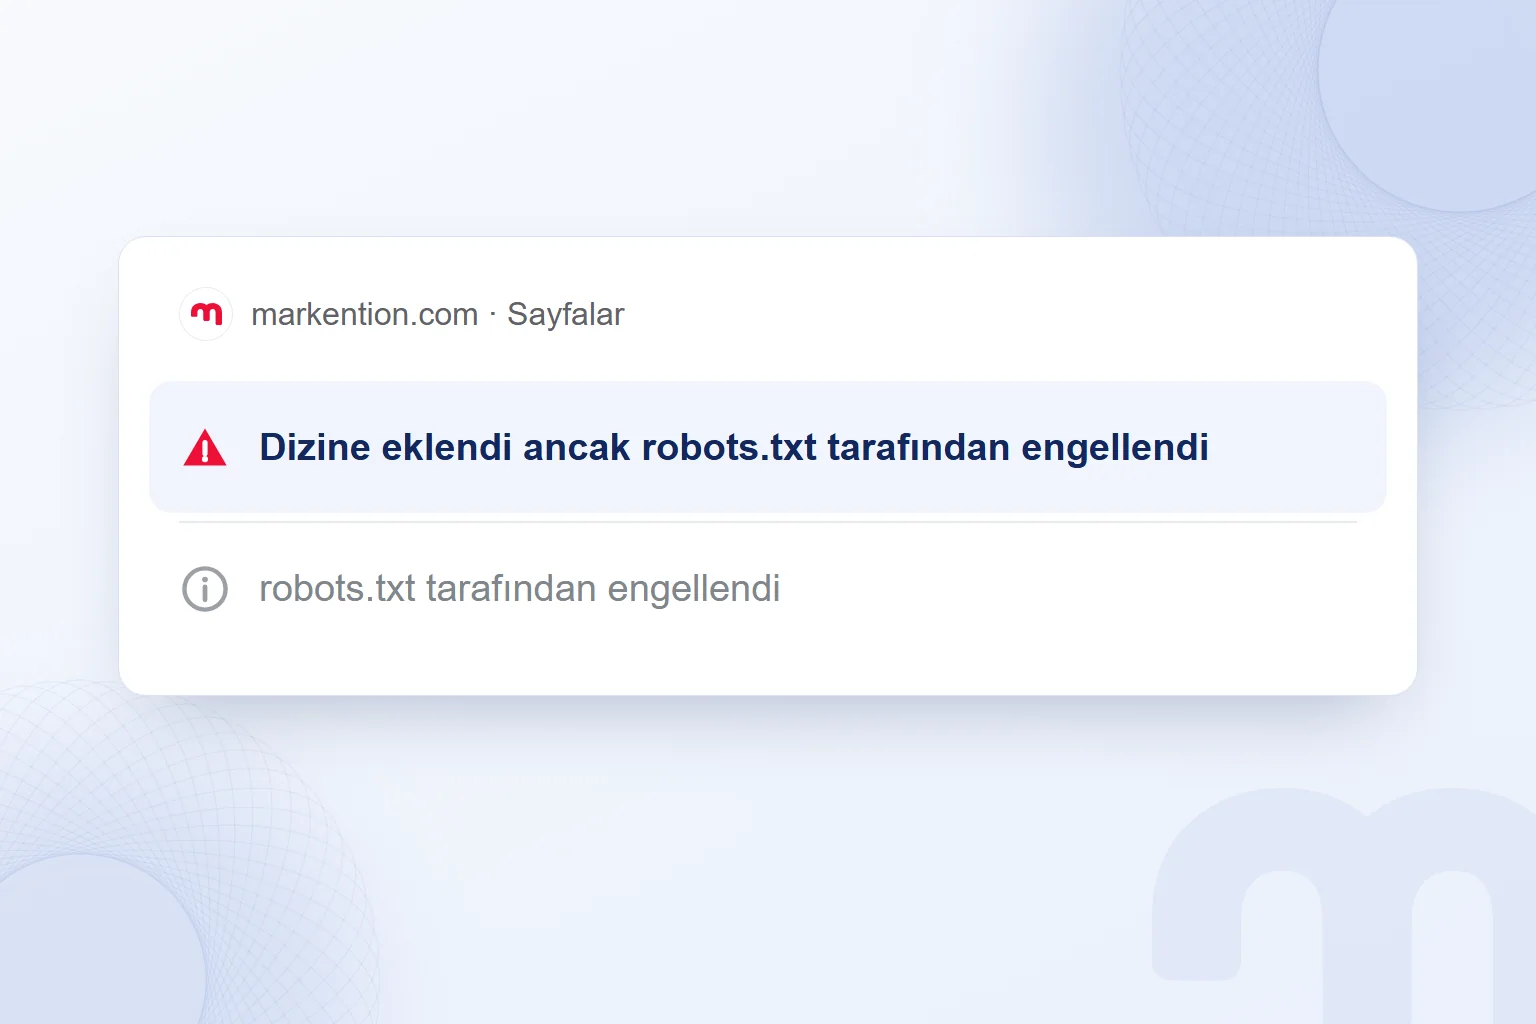
Biz sayfanın görünmemesiyle dizinden çıkarılması talebini ayırırız. Search Console’daki durum, hangi işleme ihtiyaç olduğunu gösterir.
Üç ihtimal var:
- “robots.txt tarafından engellendi” → Sayfanın taranmasını istiyorsak engelleyen kuralı düzeltiriz; ilgili botun özel grubunu da inceleriz.
- “Dizine eklendi ancak robots.txt tarafından engellendi” → Sayfayı dizinden çıkarmak istiyorsak tarama engelini kaldırır, noindex kullanırız; Google’ın yönergeyi okuyabilmesini sağlarız.
- Dosyada engel yok → Sorunu başka yerde ararız; noindex, kanonik ve içerik kalitesini kontrol ederiz.
Aynı sayfada tarama yasağıyla noindex’i birlikte kullanıp dizinden çıkmasını beklemeyiz. Biz önce hedefi belirleriz: içeriği okutmak mı, sayfayı dizinden çıkarmak mı? Sonra erişim ve dizin kurallarını bu hedefe göre düzenleriz.
robots.txt dosyasında sık yapılan hatalar
En sık yapılan hatalar, genel grubun bütün botları kapsadığını varsaymak, tarama yasağını dizinden çıkarma sanmak ve bot adına bakarak kimliği doğrulanmış saymaktır.
- Yolun harflerini değiştirmek: Kuralı gerçek adresle karşılaştırırız; /Kutuphane ve /kutuphane ayrıdır.
- Eğitimle aramayı birlikte kapatmak: GPTBot ile OAI-SearchBot izinlerini ayrı kararlaştırırız.
- Bot adına güvenmek: Sahte adları ayırmak için yayımlanan IP listeleriyle doğrulama yaparız; OpenAI listeleri openai.com/searchbot.json ve openai.com/gptbot.json adreslerindedir.
- Yalnız dosyaya bakmak: Özellikle reklam açılış sayfasında güvenlik duvarının erişimi kesip kesmediğini de kontrol ederiz.
Biz GEO danışmanlığı çalışmasında erişim kararlarını içerik hedefleriyle birlikte ele alırız. Arama ve yanıt görünürlüğüne ilişkin diğer açıklamalar GEO yazılarımız içinde yer alır.
Sık sorulan sorular
robots.txt nedir, kısaca?
Sitenin kök dizininde duran, uyumlu botlara tarama kurallarını bildiren düz metin dosyasıdır. Sayfayı tek başına Google dizininden çıkarmaz.
WordPress’te robots.txt nasıl düzenlenir?
Önce sanal dosyayı ve ilgili eklenti ayarlarını kontrol ederiz. Kök adreste görünen son çıktıyı doğrulamadan düzenlemeyi tamamlamayız.
Google robots.txt kurallarını hemen uygular mı?
Google dosyayı genellikle 24 saate kadar önbellekte tutar. Değişikliği değerlendirirken Search Console’daki son getirme durumuna da bakarız.
GPTBot’u engellemek ChatGPT aramasını kapatır mı?
GPTBot ile OAI-SearchBot izinleri bağımsızdır. Eğitim tercihini değiştirdiğimizde arama botunun kuralını ayrıca kontrol ederiz.
Google-Extended engeli Google sıralamasını etkiler mi?
Google’ın belgesine göre bu belirteç Arama’ya dahil edilmeyi etkilemez ve sıralama sinyali olarak kullanılmaz.
Disallow ile noindex aynı işi mi yapar?
Hayır; Disallow taramayı sınırlar, noindex dizine alınmamayı bildirir. Google’ın noindex’i okuyabilmesi için sayfanın taramaya açık kalması gerekir.
Bu konuda devam edin
 ChatGPT’de Reklam Vermek: Ads Manager, Hedefleme ve İlk Kampanya RehberiYazıyı oku
 Google’da reklam verme: Google Ads hesabı, ilk kampanya, bütçe ve ölçümYazıyı oku
 LLM nedir? Büyük dil modelleri nasıl çalışır, markanızı nereden tanırYazıyı oku
 TikTok keşfet saatleri: en iyi paylaşım saatini hesap verisiyle bulmakYazıyı oku
 Optimize ne demek, optimizasyon nedir? Telefonda, sitede ve reklamda optimize etmekYazıyı oku
 Dashboard ne demek? Pazarlama panosu, KPI seçimi ve Looker StudioYazıyı oku
 URL ne demek, URL nedir? Adresin parçaları, slug ve SEO’daki yeriYazıyı oku
 Prompt ne demek? Yapay zekâya istek yazmak ve prompt mühendisliğiYazıyı oku
Soru & Cevap
0 yorumHenüz soru yok; ilk soruyu siz sorabilirsiniz.